
Technology
技術基盤
公開している結果を支える技術基盤の概要です。詳細はそれぞれの 技術報告書(DOI)本体に委ねており、このページはあくまで概要と 参照先の案内にとどめています。
データセットと4つのAIモデル
公開しているブロック単位データベースは全て、同じ元データから 構築しています:NIH ChestX-ray8データセットの5,004枚のオリジナル画像を、それぞれ 重なりのない8×8ピクセルのブロックに分割したもので、 モデル1つあたり81,975,528ブロックになります。
出典:Wang, X., Peng, Y., Lu, L., Lu, Z., Bagheri, M., & Summers, R. M. (2017). ChestX-ray8: Hospital-scale chest x-ray database and benchmarks on weakly-supervised classification and localization of common thoracic diseases. Proceedings of CVPR, 3462–3471. データセットは NIH Clinical Centerから入手できます。
各画像は、2つのアーキテクチャにまたがる4つのAI超解像モデルで 復元しています:
- Upscayl Standard(GANベース)
- Upscayl High-Fidelity(GANベースの派生モデル)
- Upscayl Digital-Art(GANベースの派生モデル)
- SwinIR(Transformerベース)
UpscaylはオープンソースのAI 画像アップスケーラーで、今人気があり、無料で使えることから 選びました。Standard・High-Fidelity・Digital-Artは、いずれも Upscaylに標準で 同梱されているモデルで、いずれもGANベース、特別な選定基準は 設けずそのまま使っています——同じツールの複数のバリエーションで 同じ分析を行えば、それだけで何らかの傾向が見えてくるはずだと 考えたためです。 SwinIRは それとは別の、広く使われているTransformerベースの超解像モデル (Liang et al., 2021)で、同じアーキテクチャの派生形だけでなく、根本的に 異なるアーキテクチャにまたがっても私たちの知見が成り立つかを 検証する目的で含めています。
各モデルは、技術報告書全体を通してnoTTA・ TTAと表記される2つの条件でも実行しています (TTAはtest-time augmentationの略で、入力画像に変換を加えた 複数のバージョンからそれぞれ復元して平均を取る、推論時によく 使われる手法です)。超解像(Super-Resolution)分野の論文では、 この手法は一般にself-ensembleと呼ばれます ——EDSR論文が提唱した"geometric self-ensemble"という手法名に 由来する呼び方です。「TTA」はコンピュータビジョン全般で使われる、 より広い総称にあたります。
このサイトの他の箇所と同様:モデルごとの結果を公開することは、 これらのモデルの優劣を格付けしたり推奨したりするものではありません。 よくある質問を参照してください。
DuckDBによるローカル大規模分析
SQLiteからの乗り換え
当初はSQLiteを使って分析していましたが、億単位のブロックデータを 扱うにつれて、1回のクエリに数十分〜数時間かかることも珍しくなく なり、実用的な分析速度ではなくなっていきました。そこで乗り換えた のが、列指向の分析用データベースであるDuckDB です。同じ規模のデータでも、通常のPC上で数秒〜数分程度で処理 できるようになり、実際のSQLクエリを画面録画し、その場で結果を 示す——という形の検証動画を、各技術報告書で公開できるように なりました。これは単にコードやデータを公開するだけでなく、 実験そのものを実演して見せることに近い、より直接的な形の 透明性です。
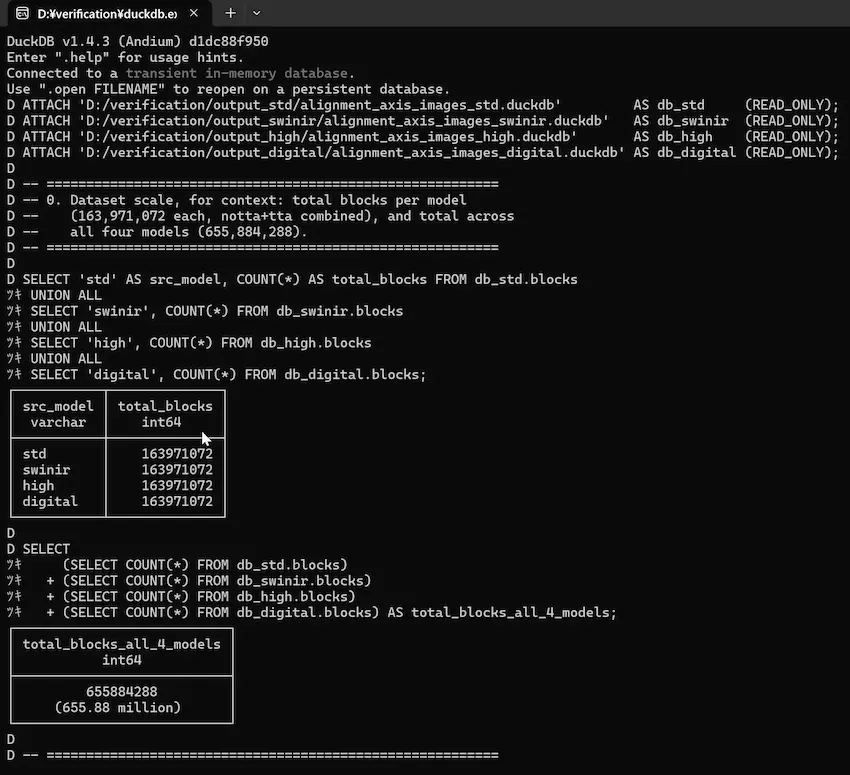
DuckDBは、しばしば「分析用のSQLite」と呼ばれます。SQLiteが 少量データへの逐次的な読み書き(トランザクション処理)に最適化 されているのに対し、DuckDBは列指向のストレージと、大量データの 集計・走査に特化した実行方式を採用しており、まさに分析 ワークロードのために設計されています。しかもSQLiteと同じく、 サーバーを立てる必要のない組み込み型データベースで、通常のPC 1台で完結します。この設計思想を知り、「自分たちの用途にまさに 合っている」と考えたのが、採用の決め手でした。
DuckDBの開発は、オランダの非営利団体DuckDB Foundation (Stichting DuckDB Foundation)が統括しています。理事はHannes Mühleisen・Mark Raasveldt・Peter Bonczの3氏で、AWS・MotherDuck・ Positなどの企業がスポンサーとして開発を支えています。
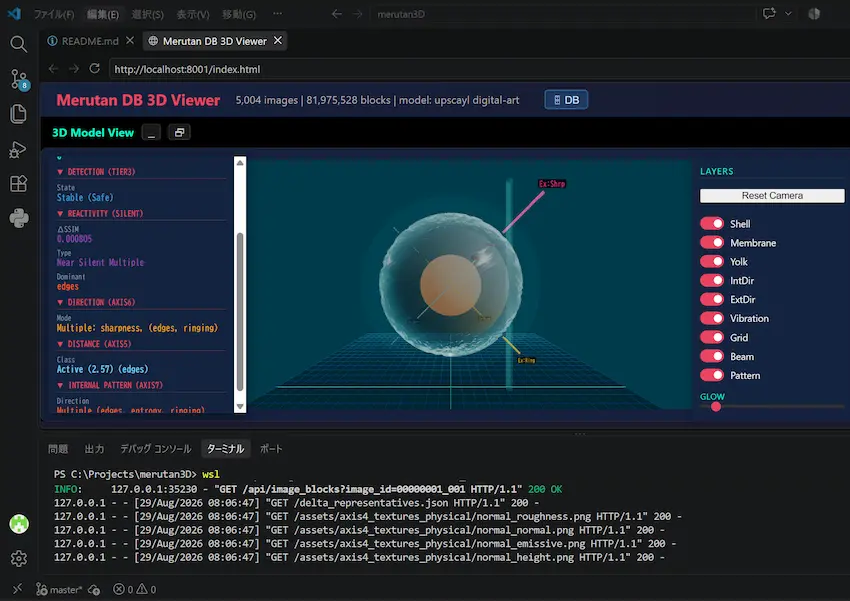
あまり見かけない組み合わせ:DuckDB+ライブ3Dビューア
DuckDBをインタラクティブな可視化のライブバックエンドとして 使うこと自体は、実は珍しくありません——Mosaicや MotherDuckの事例のように、数千万行規模のデータを2Dチャートで 探索するのに使われており、多くはDuckDB-Wasm(ブラウザ内で DuckDB自体を動かす方式)を採用しています。私たちが調べた 範囲で前例が見つからなかったのは、3Dブロックビューアで 使っている、もっと具体的な組み合わせです:全てクラウドを介さず 単体のPC上だけで動作します——ローカルのFastAPI Webサーバーが DuckDBに直接クエリを投げ(DuckDB自体はブラウザには組み込んで いません)、その結果をThree.jsで「3D」として可視化する、という ものです。崩壊に関する16〜20次元相当の情報を、次元圧縮なしに 卵型モデルの独立した視覚チャンネルへマッピングしています。 調べた範囲では、2026年8月時点で、この組み合わせは珍しい 使い方だったと言えそうです。
SQLを選んだ理由
もう一つの決め手は、従来のように専用のPythonライブラリを介さず、 SQL文だけで分析を完結できることでした。Pythonなどの汎用言語で 書かれた分析コードは、複雑になるほど「裏で何か手を加えている のではないか」という疑念を招きやすくなります。SQL文であれば、 何を計算しているかがクエリそのものから直接読み取れ、同じ結果を 第三者が別途同じクエリを実行するだけで再現・検証できます。この 分かりやすさ・検証のしやすさが、私たちにとって重要でした。
動画証拠としての工夫
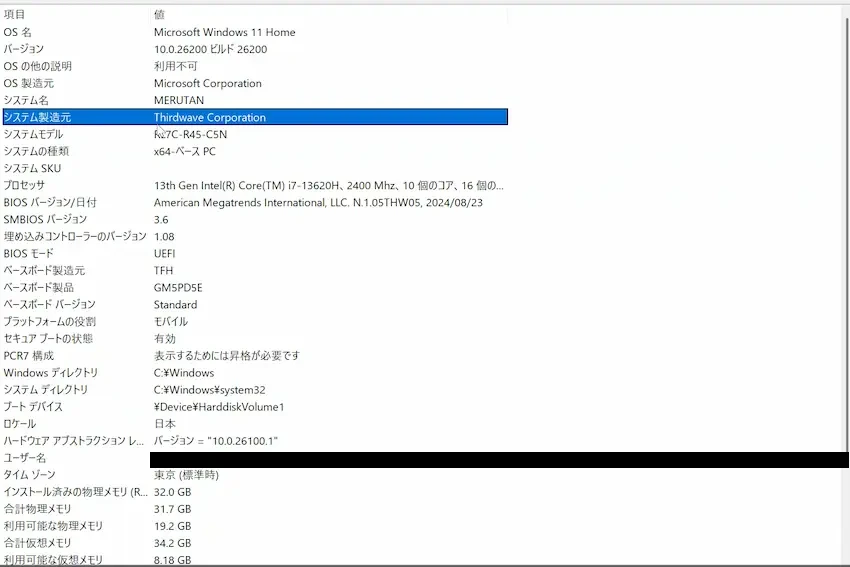
実際にDOIシリーズでは、SQL文そのものと、それを実行する様子を 録画した動画を公開してきました。ただ、動画を公開するだけでは、 「本当にローカルPC上で実行しているのか」という疑念を持たれる 可能性も残ります。そこで途中から、録画の冒頭でPCのシステム情報 (OS・スペックなど)を映してから、SQLを実行するリアルタイムの 様子を撮影する、という形に変えました。
JOINなし検証パイプライン
もともとの分析基盤は、SSIMの計算結果と、別途生成したcomp_* 特徴量のテーブルを、座標情報でJOIN(結合)する設計になって いました。ところが、このJOINの過程で、行が正しく対応付け られないデータ整合性のバグが繰り返し見つかりました——値が 本来入るべきでない0のままになっていたり、別のブロックの値が 紛れ込んでいたりするケースです。しかもこの種のバグは、単純な チェックだけでは検出できないこともありました。
厄介だったのは、同じ仕組みで作ったデータベースでも、正しく 作れたものと、実際に問題が起きていたものが混在していたことです。 億単位の規模のデータでは、こうした一部の不整合は目視ではすぐに 気づけず、静かに紛れ込んだまま見過ごされかねません。だからこそ、 個々のバグを都度直すのではなく、JOINという仕組み自体を取り除き、 この種の問題が原理的に起こり得ない設計に切り替える必要が ありました。
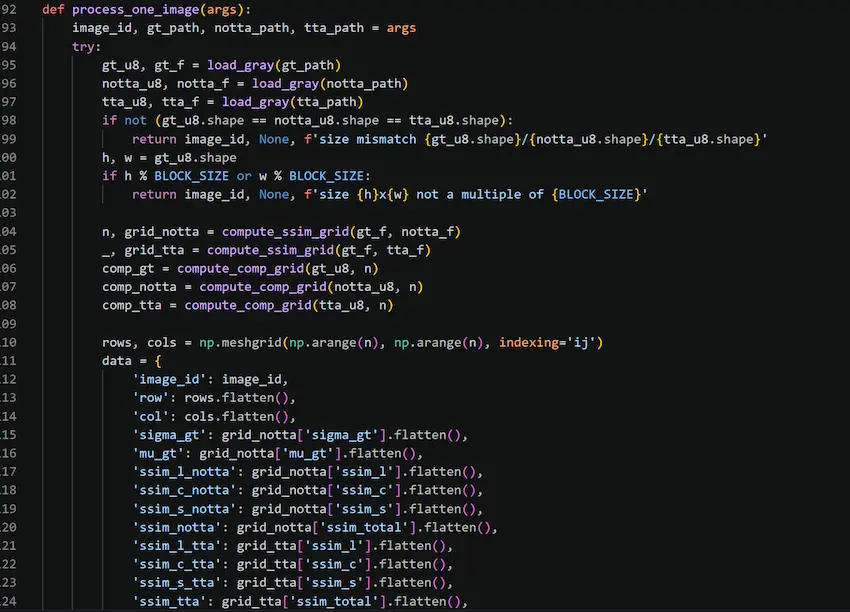
私たちの検証用データベースは、comp_*特徴量とSSIM値を、複数 テーブルのJOINに頼らず、各再構成画像から直接1パスで計算します。 これにより、以前のJOINベースの設計で繰り返し見つかった、 データ整合性のバグ(JOINによる行の取り違え)を構造的に回避 しています。 DOI 1.12 で初めて確立された手法です、詳細はそちらを参照してください。
この設計の実際のコード(build_notta_tta_comp_db.py
・heatmap_tool.py)は、実演動画とともに
DOI 1.19.1
として全文公開しています。自分のデータで実行する方法は
検証用データベース
の構築、仕組みのセクションごとの解説は
初心者向け
コード解説を参照してください。
comp_*特徴量フレームワーク
SSIMだけでは捉えきれない、ブロックの構造・テクスチャの質を 診断するための8つの特徴量(鮮明さ・エッジ・アーティファクト・ コントラスト・質感・情報量・ノイズ)です。詳細な定義と実装は DOI 1.8 に記載しています。
この8つのうち1つは、誰も想定していなかった使い道が見つかり
ました:comp_contrastを255で割ると、モデル自身が
復元したコントラストの誤差ゼロの厳密な測定値になります——
DOI
1.20.1では、これを使ってGTを一切使わずにSSIMの
Structural Maskingリスクを見抜けることを示しました。この結果と、
もう一つのSSIMの弱点に対するGTなしツールについては、
平易な解説
ページをご覧ください。
comp_*の8つの特徴量は、数式・実装コードまで含めて正式に 公開しています。何をどう計算しているかが明確になることで、 読む側にとって理解しやすくなるだけでなく、私たちが掲げる オープンサイエンスの実践そのものでもあります。
この8つの特徴量は最終形ではない。comp_*フレームワークとDB構築 パイプライン(Technical Report v1.19.1で公開)はどちらも、開発者 が独自の診断特徴量を同じ条件セットに追加し、自分の用途に合わせた 評価ツールを構築できるように設計されている。画像品質指標の信頼性 を、AIセキュリティという、より広い文脈の一部として捉え、優秀な 開発者にどんどんこの取り組みに参加してほしいと考えている。