DOI1.12以降の検証SQLレポート全部を支える、モデルごとの4つの データベースを構築するスクリプトです。8×8ピクセルの画像ブロック 1つにつき1行、ground truth・TTAなし復元・TTAあり復元それぞれに 対して独立にSSIMと8つのcomp_*特徴量を計算します。
| 入手先 | 元々はDOI 1.12のZenodoアーカイブ(Merutan_DOI1.12.zip)に同梱、以降無改変。heatmap_tool.py・実行動画とともに、単体で無編集のままDOI 1.19.1として再公開済み |
|---|---|
| 初出 | DOI1.12(技術基盤ページで説明しているJOIN由来のデータ不整合バグへの対策として確立) |
| 使用範囲 | DOI1.12〜1.16——このスクリプトが作る4つのデータベースは、以降のレポートで無改変のまま再利用され続けており、再実行や編集は一度もされていません |
| 状態 | 現行版——訂正版は存在しません |
このコードが初めての方へ:セクションごとの初心者向け解説はこちら →
ground truth・TTAなし復元・TTAあり復元の3種類が揃っている画像 それぞれについて、このスクリプトは:
技術基盤ページで説明している 設計変更——別々に生成した表を後からJOINするのではなく、読み込んだ 同じ画像群からSSIMとcomp_*を1回のパスで直接計算する——を、実際に 実装したものがこのスクリプトです。以前のJOINという工程は、数億行 規模のスケールで、繰り返しデータ不整合バグの発生源になって いました——詳しい経緯は同ページを参照してください。
1回の実行につき、DuckDBデータベースファイルが1つ生成されます ——指定するのはground truthフォルダ1つと、復元結果フォルダ2つ (TTAなし・TTAあり)です。複数のモデルを比較したい場合は、 モデルごとに1回ずつ実行してください。私たち自身が公開している レポートの元になっている4つのデータベース(Standard・SwinIR・ High-Fidelity・Digital-Art)も、この方法で1モデルずつ実行して 作成したものです。それぞれ2つの表を含みます:
Python 3に加えて、numpy・pandas・
duckdb・pillow・
opencv-python-headless・scikit-image
が必要です。また、同じディレクトリにheatmap_tool.py
も必要です——このスクリプトが直接関数をimportして使っています。
heatmap_tool.py自体の1画像単位の可視化機能はまだ
改良中で、その作業が固まり次第、独立した技術報告書として発表
する予定です。ソースコード自体は、下記のDOI 1.19.1で本スクリプト
と一緒にそのまま公開済みです。
python3 build_notta_tta_comp_db.py \
    --gt-dir /path/to/gt_images \
    --notta-dir /path/to/notta_recon \
    --tta-dir /path/to/tta_recon \
    --out std_notta_tta_comp.duckdb \
    [--workers N] [--chunk-size 20] [--limit N]
1回の実行で、1組の復元結果フォルダとground truthフォルダ1つを
比較する。複数のモデルを同じground truthと比較したい場合は、
--gt-dirを共通のまま、モデルごとに1回ずつ実行する。
--workersは並列処理する画像数を制御する(デフォルトは
CPUコア数マイナス2——実行中もマシンを他の作業に使えるように
するため)。--limitは新規処理する画像数の上限を
指定でき、本番実行の前に少数で動作確認したい場合に便利。
いつ中断しても安全——クラッシュ、再起動、手動での停止、いずれも 問題ない。同じコマンドで再実行すると、出力先データベースの images表に既に記録済みの画像は自動的にスキップ されるため、中断した実行は最初からやり直すのでも重複行が生じる のでもなく、続きから再開する。
DOI 1.19.1をZenodoで見る:https://doi.org/10.5281/zenodo.22838600
本スクリプトとheatmap_tool.pyは、2026-09-01時点の
状態のまま——DOI 1.12からv1.16まで全ての数値を実際に生成した、
まさにそのコードとして——単体のレポートとしても公開されています。
誰でも自分自身のground truth/TTAなし復元/TTAあり復元の画像
フォルダを指定して、同じ種類のデータベースを自分のデータ・
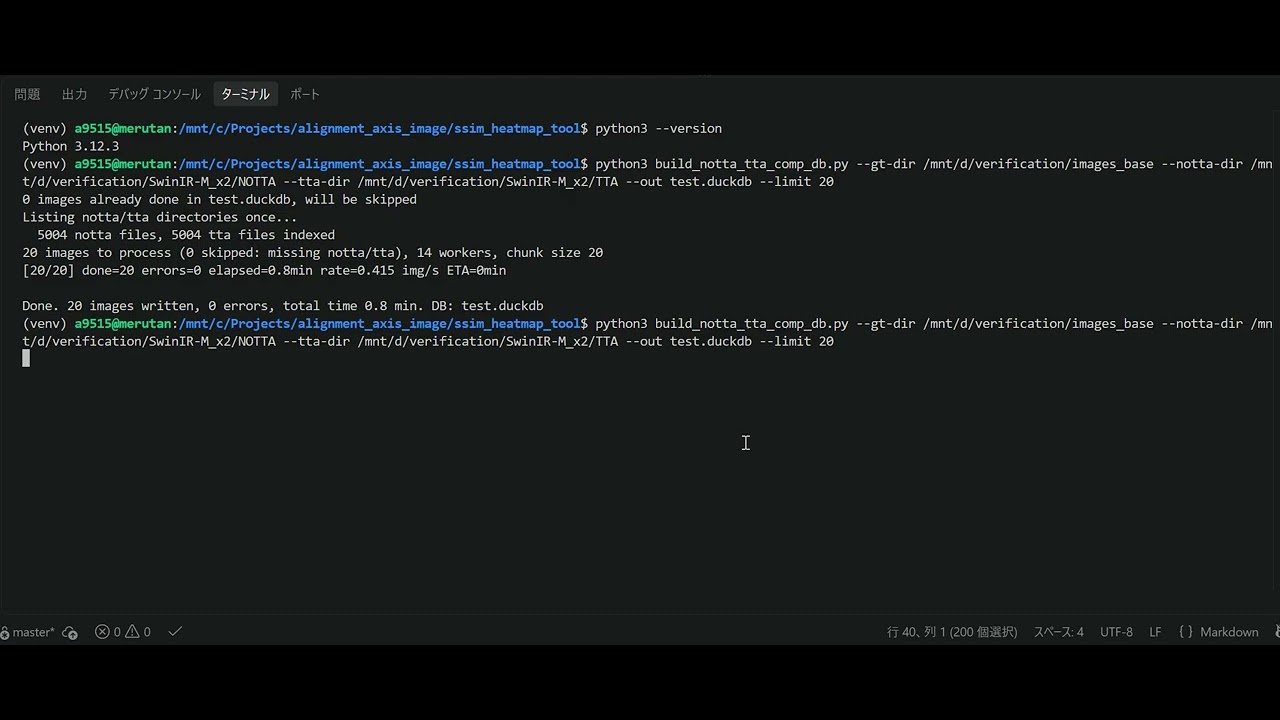
モデルで構築できます。下の動画は実際の実行の様子
(--limit 20)を2回連続で撮影したもので、2回目が
既に処理済みの20枚を正しく検知し、次のバッチに進む様子——つまり
中断・再開が実際に機能することを示しています。
DOI 1.19.1では、この状態のまま無編集で公開したことに伴う制限
事項も2点明記しています:heatmap_tool.pyが生成する
HTMLの説明文は日本語のみであること、そしてSIGMA_STAT
辞書がこのプロジェクト自身のデータセット・4モデル専用にハード
コードされていること(SIGMA_Cは数式由来の普遍的な
値なので、この注意は不要)。自分のデータセット・モデルに適用
する場合は、これらの値をそのまま使わず、自分自身の
SIGMA_STATを改めて導出してください。
build_notta_tta_sigma_db.pyDOI 1.21をZenodoで見る:https://doi.org/10.5281/zenodo.23271571
build_notta_tta_sigma_db.pyは、DOI 1.21のために
書かれた本スクリプトの派生版です。同じheatmap_tool.py
に依存し、全体のアプローチ(モデルごとに独立した、JOINなしの
データベース、チャンク単位で再開可能)も同じですが、スキーマを
拡張しています:本スクリプトが保存する派生特徴量
comp_*に加えて、
σnotta/μnotta/σtta/μtta
を生値として追加保存します。これはDOI 1.21の浮動小数点
「影の重複」
の訂正を、派生特徴量経由ではなく直接測定するために必要でした。
構築したデータベースの使い方は DOI 1.21のSQL解説を参照してください。