
Home
SSIMには、数式で証明できる「盲点」がある——閉形式の証明と、大規模実データによる検証。
科学は、正直であるべきだと思っています。都合の良い結果だけを 見せるのではなく、間違いも含めてすべてを検証可能な形で示す こと——それがオープンサイエンスに共感した理由であり、 Meritcs(メリティクス)の活動の出発点です。
SSIM(構造的類似性指標)のような画質評価指標が、いつ信頼でき、 いつ信頼できなくなるのか。その境界を、数式による証明と、 数千万ブロック規模の実データ検証の両輪で、地道に確かめ続けて います。
特定のモデルの優劣を主張することではなく、指標を正しく 使うための手法そのものを確立し、検証可能な形で公開することを 目的としています。
なぜ重要か
SSIMのような画質評価指標は、AI画像の高解像度化から医療画像処理 まで、モデル評価のあらゆる場面で使われています。その指標が 意図的に操作されたり、静かに機能不全に陥ったりすれば、その 上に築かれたベンチマークはすべて、同じ盲点を抱え込むことに なります。実際には失敗しているモデルが、誰にも気づかれない まま「うまくいっている」ように見えてしまう——だからこそ、 これは重要な問題なのです。
何がわかるようになるのか
この手法の核心は、モデルの内部(学習データ・アーキテクチャ・ 重み)に一切アクセスせず、外部から観測できる入出力画像の統計量 だけで、モデルの挙動を診断できる点にあります。実際、独立に 学習された複数の モデルを同じ手法で検証したところ、指標が構造的に機能しなくなる 領域での振る舞いや、復元結果がGTにどれだけ忠実かといった性質が、 モデルごとに異なることを確認しています(詳しくは 発行物一覧を参照)。
この「外部からの診断」という性質には、実務上の応用可能性もあると 考えています——内部にアクセスできない第三者モデルの品質評価、 モデルのバージョンアップ時の挙動変化の検知、医療画像のような高い 信頼性が求められる領域での独立検証など、今後の展開として 期待しています。
主要な発見
- SSIMのスコアが、実際の復元品質を反映しなくなる境界を、閉形式の数式で導出
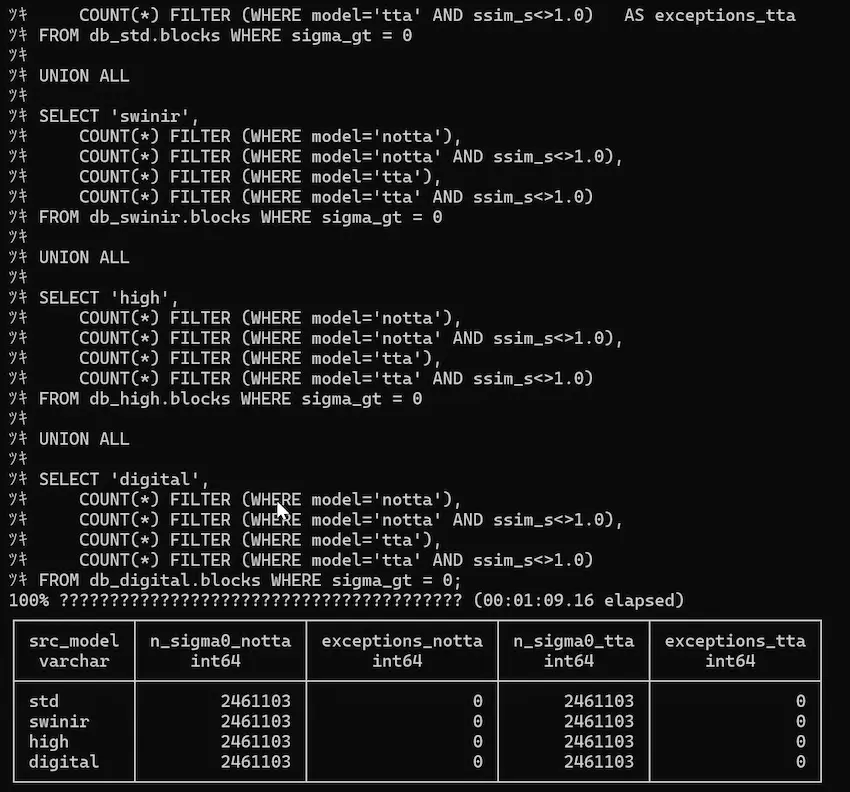
- 「マスキング盲点」の証明——平坦な領域では、中身に関係なく指標が数式的に満点近くへ強制される(σgt = 0 ⇒ S = 1)
- 独立に学習された4つのモデルにわたる実証により、SSIM単体でも補助的な特徴量チェック単体でも、どちらも単独では不十分であることを確認